 AI FactScan
不要只讀 AI 的答案。
要看它引用了什麼。
適用於 ChatGPT、Claude、Gemini 等平台的瀏覽器擴充功能
「AI 可能會出錯」,但到底錯了多少?
AI FactScan 幫你找出 AI 幻覺引用與不可靠來源。
每一筆引用,即時分級。
瀏覽器擴充功能,支援 ChatGPT · Claude · Gemini · Copilot · Grok · Perplexity · DeepSeek
權威來源還是隨機部落格?
我們幫你評級,不需要你猜。
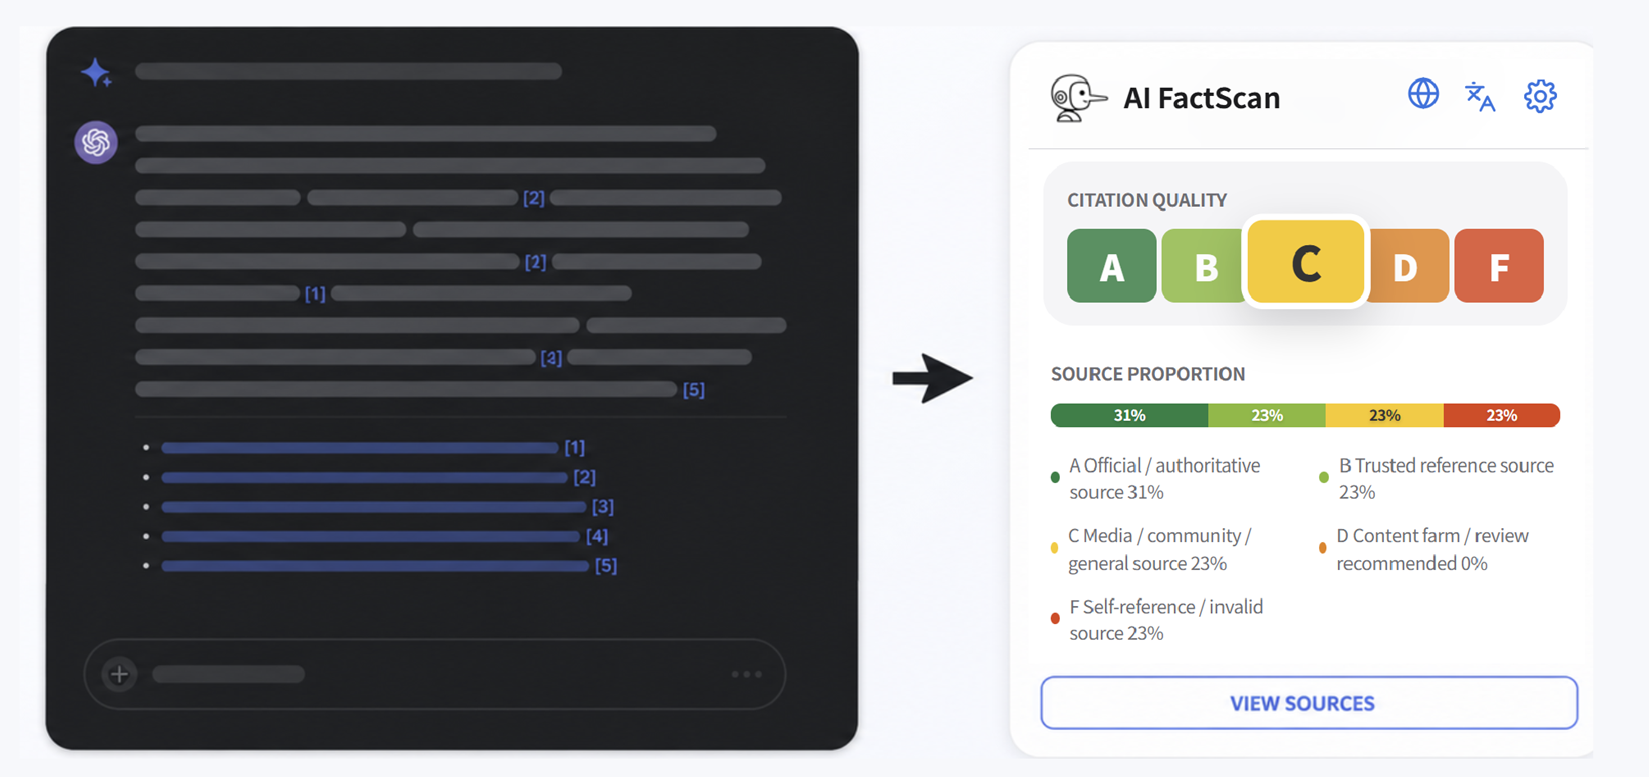
就算你打開每一個連結—你真的能判斷來源的品質嗎?我們在幾秒內為每筆引用評出 A 到 F 等級。
你來決定要信什麼。
評分依據來自真實世界的來源資料。
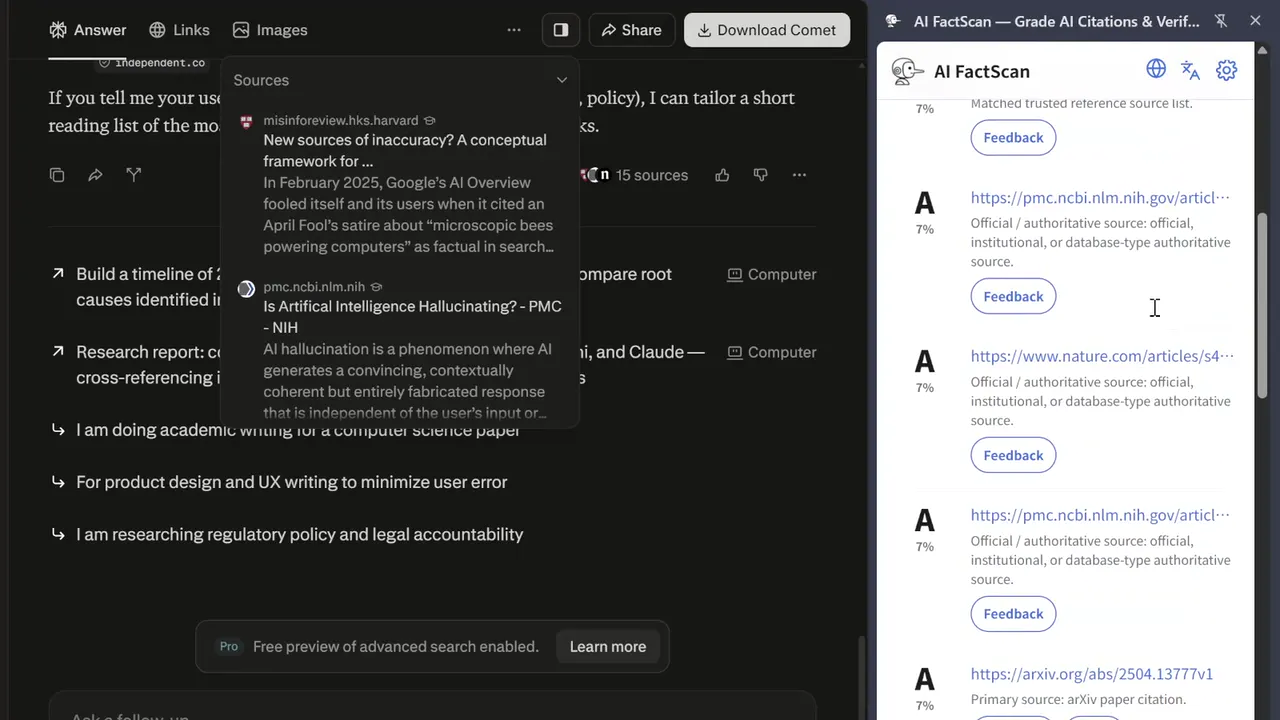
AI FactScan 先替你完成事實查核的第一關:檢查引用是否有效、評估 A–F 來源品質,並指出值得優先查閱的資料。
維度一:模型幻覺風險
AI 幻覺率參考 Vectara Hallucination Leaderboard 指標,提供 ChatGPT、Gemini、Claude、DeepSeek 等系統的模型風險背景。
維度二:權威與參考訊號
公開來源訊號包含 SCImago 排名、Crossref、OpenAlex、DOAJ、WHO、OECD、BIS,以及官方政府與機構目錄。
維度三:負面與審查訊號
CRED-1 負面訊號、內容農場名單、無效解析器檢查,以及 AI 自我引用偵測。
支持 AI FactScan
完全免費。
如果覺得有用,你可以支持我們持續更新資料庫,讓 AI FactScan 協助你判斷 AI 引用來源品質。
- 無限次引用分析
- 每次分析即時查詢雲端來源訊號
- 引用驗證(DOI / arXiv / PubMed)
- 來源集中度分析
- 完整 HTML 報告匯出
- 優先取得最新資料庫更新
- 最多可用於四個瀏覽器安裝環境
免費方案每日 5 次掃描,無需註冊帳號。
成為 Supporter
隱私,從設計開始。
引用來源檢查在你的裝置上執行。Supporter 查詢時只傳送網域名稱給伺服器—完整網址、頁面內容、AI 回應,一律不離開你的裝置。
你可能想知道
先查看低評級或帶有警示訊號的引用。優先打開這些來源,比對證據與 AI 回答,再要求 AI 替換薄弱或缺乏支持的引用。
小技巧:要求 AI 正確附上連結。把以下指令貼進 LLM 設定:
1. 所有事實性陳述,必須附上原始來源網址。
2. 若找不到來源,請明確說明不確定,不要編造。
3. 引用格式統一使用 URL、DOI、arXiv ID 或 PubMed ID。
AI FactScan 先檢查引用來源是否存在、評估來源品質,並找出需要優先注意的資料。接著你可以閱讀證據,針對缺乏可靠支持的論點回頭質問 AI。
AI 有三個引用問題:幻覺(連結指向不存在的文章或域名)、自我引用(Google 引用 Google 產品、OpenAI 引用 OpenAI blog),以及空連結(href="" 點開跳回 AI 平台首頁,看起來像引用但實際上什麼都沒有)。AI FactScan 同時偵測這三種。
A — 官方/權威來源(同行評審期刊、政府機構、主要國際媒體)
B — 可信參考來源(有編輯標準的媒體與機構)
C — 媒體/社群/一般來源 — 引用前建議確認
D — 內容農場/建議審閱 — 請謹慎使用
F — 自我引用/無效來源(AI 自我引用或空連結)
GPTZero 偵測文字是不是 AI 寫的。AI FactScan 偵測 AI 給你的來源可信度。兩個問題不一樣。
ChatGPT、Gemini、Claude、Perplexity、Grok、DeepSeek、Microsoft Copilot。
每組 Supporter 授權最多可用於四個瀏覽器安裝環境。Chrome、Edge 與不同瀏覽器 Profile 會分別計算。