 AI FactScan
AI 摘要已經不知不覺融入了我們的日常生活
根據皮尤研究中心(Pew Research Center)的調查,高達 60% 的美國成年人平時都會閱讀出現在搜尋結果頂部的 AI 摘要。你很可能也是其中之一。對許多人來說,如今搜尋任何問題,第一眼映入眼簾的早已不再是傳統網站,而是 AI 寫好的一大段總結。
這種模式的吸引力顯而易見:看一段摘要,比一次開五個分頁比對輕鬆得多;比起硬啃生澀的研究論文,AI 的文字也親切得多,而且語氣往往自信滿滿,彷彿事情早有公論。然而,這種「太方便」的體驗正在悄悄改變我們的閱讀習慣——當眼前的答案看起來條理分明、架構完整時,我們往往會放鬆戒心,忘了去追問:「等等,這些結論到底是從哪裡來的?」
這正是潛在風險的起點。能讓一份好摘要清晰易讀的精美包裝,同樣能讓一份缺乏扎實佐證的敷衍回答顯得無比可信。
那麼,我們到底能不能相信 AI 的摘要?
答案是:要看這份摘要是怎麼做出來的。如果只是把一份指定的現成文件濃縮成大意,跟從整個網路四處抓資料拼湊出來的回答,風險完全是兩回事。
一項發表於 2025 年的隨機對照試驗發現,在總結著名的考科藍實證醫學文獻(Cochrane reviews)時,AI 輔助生成的摘要品質幾乎跟專業人類寫的一樣好。但請注意,這項測試有一個至關重要的安全防線:在拿去測試之前,每一份摘要都經過專業人員親自檢查並修正了錯誤。
然而,你在開放網路上遇到的絕大多數 AI 回答,背後可沒有專業編輯幫你把關。它們很可能會把好幾個網頁的零碎資訊混在一起、直接省略所有尚無定論的限制條件,甚至把一筆看似權威的真實引用,硬塞在一句該文獻根本沒提過的主張旁邊。換句話說,就算網址點得開、就算連結千真萬確,也不代表它能證明 AI 說的每一句話。
真實的引用,依然可能完全文不對題
一項刊登於頂尖期刊《自然-通訊》(Nature Communications)的 2025 年研究,針對 AI 在醫療健康回答中的引用品質進行了實測。在評估 300 個一般大眾常見的健康問題時,具備網路檢索功能的 GPT-4o 雖然給出的都是有效網址,但整篇回答中能得到參考文獻「完整實質支持」的比例,竟然只有 38.4%。這項數據雖然來自醫療領域的測試,但帶給我們的啟示放諸四海皆準:「網址連結能不能點開」與「內容能不能證明結論」,完全是兩碼子事。
流暢漂亮的文筆,往往掩蓋了不確定性
AI 的回答極少顯露出猶豫不決的樣子。哪怕背後的參考資料殘缺不全、爭議極大,交到你手中的文字依然看起來從容篤定、隨取隨用。但請記住:這項決策越重要,你就越不能只憑 AI 說話的自信語氣來做判斷。無論是醫療就診、法律書狀、投資理財、課堂期末報告,還是交付給客戶的工作成果,都值得你多停下來看一眼。
一篇名為 Answer Bubbles 的研究論文,測試了多款主流 AI 搜尋產品與 Google 搜尋上的 11,000 個真實問題。研究發現,AI 摘要往往傾向展現高度自信,刻意壓縮甚至省略了學界原本存在的爭議與不確定性。簡而言之,在現實世界的事實證據還在激烈辯論時,AI 的文筆就已經急著把話說死了。
如何查驗一份 AI 摘要?手把手實戰指南
千萬別傻傻地從第一句開始逐字苦查,那會累死人。聰明的做法是:先找出那幾句「如果它是錯的,就會完全改變你的結論」的關鍵主張,然後仔細檢視這幾句話到底踩在什麼證據之上。
步驟 1:把背後的參考來源通通找出來
如果 AI 給的答案裡半個引用都沒有,直接要求它:「請附上原始研究、官方公文或第一手資料的直接網址連結。」如果一句關鍵主張連出處都查不到,光看 AI 自己的文字根本無從查證。
如果 AI 已經附上了參考資料,點開來源清單看看,先別被那一長串數字唬住了。很多時候,看似滿滿的十幾個角標,點進去其實全都連向同一篇新聞、同一個機構的宣傳頁,甚至只是一張搜尋結果清單。
步驟 2:一鍵掃描所有引用的參考來源
這時,AI FactScan 能幫你完成最耗時的第一輪快篩。打開擴充功能,點選「手動選取(Select manually)」,然後點一下畫面上包含參考資料的 AI 回答,擴充功能就會自動把所有連結抓出來同步健檢。
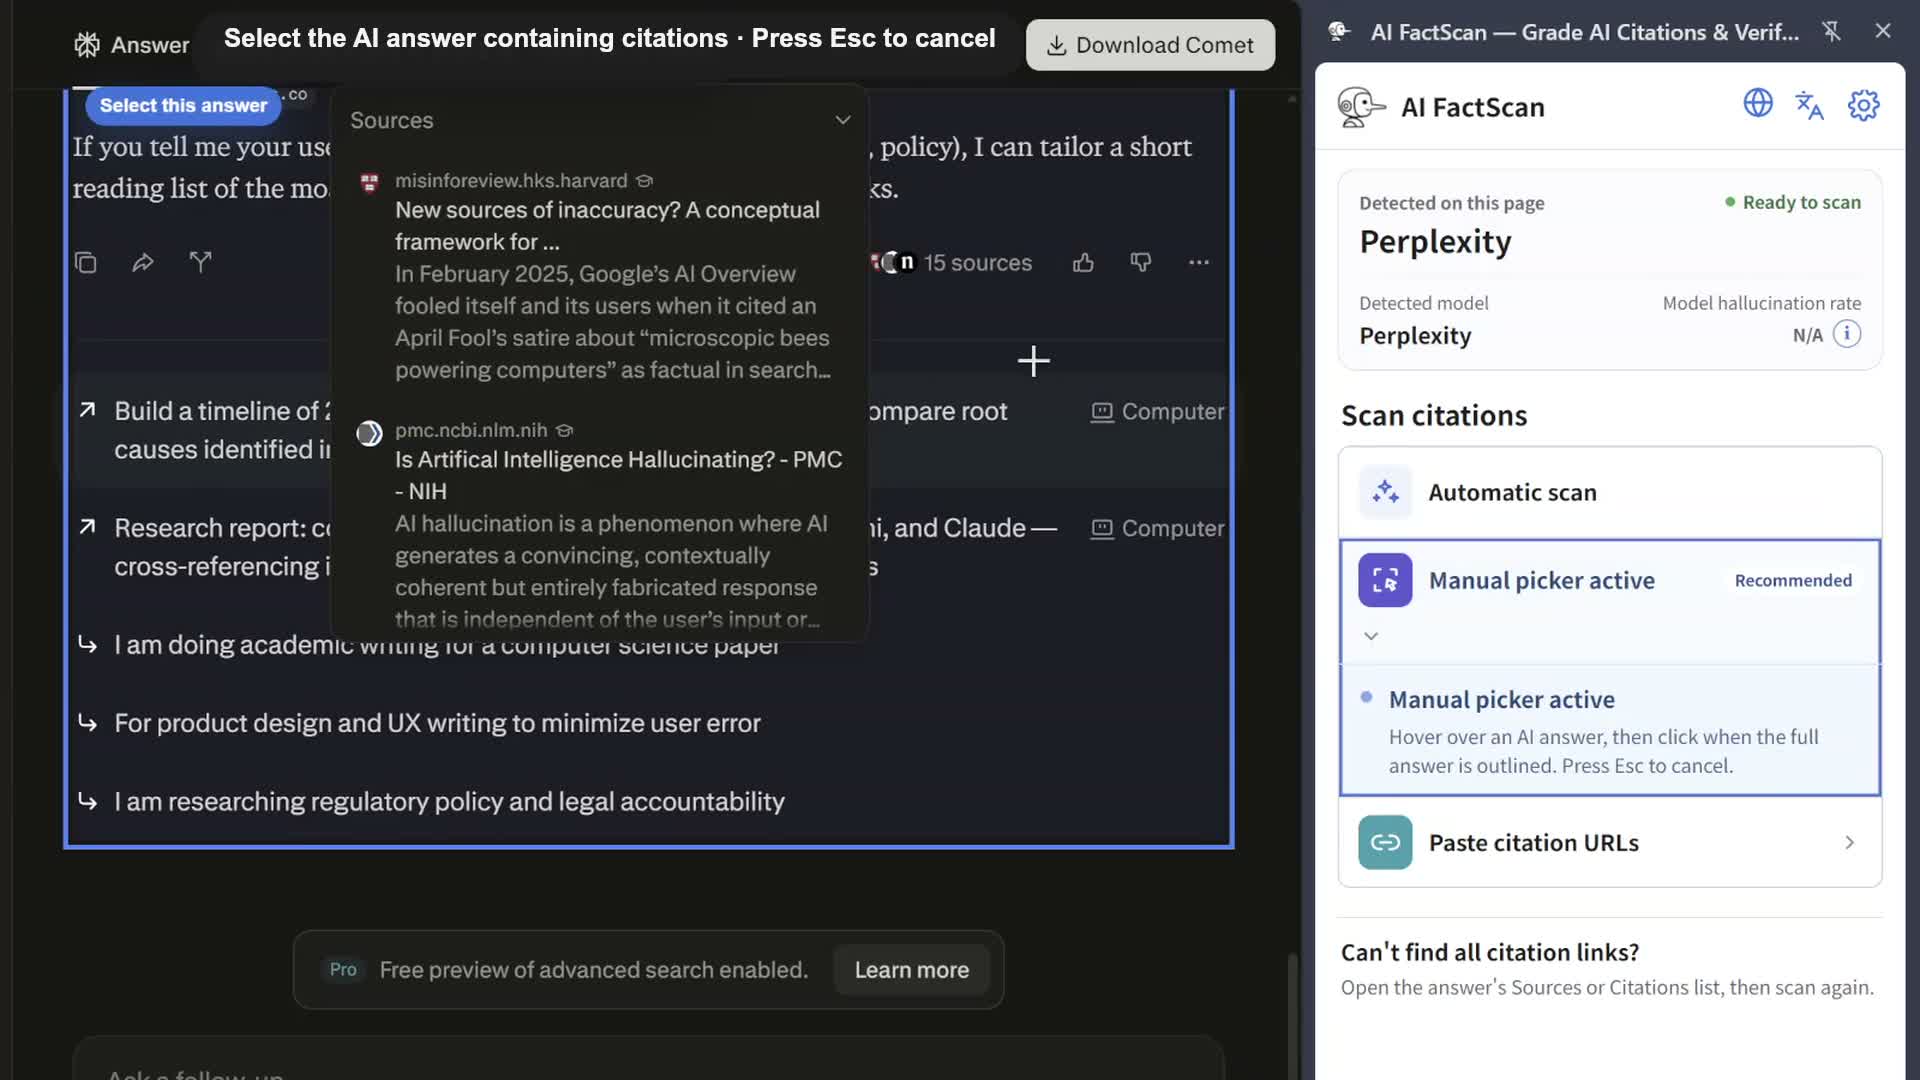
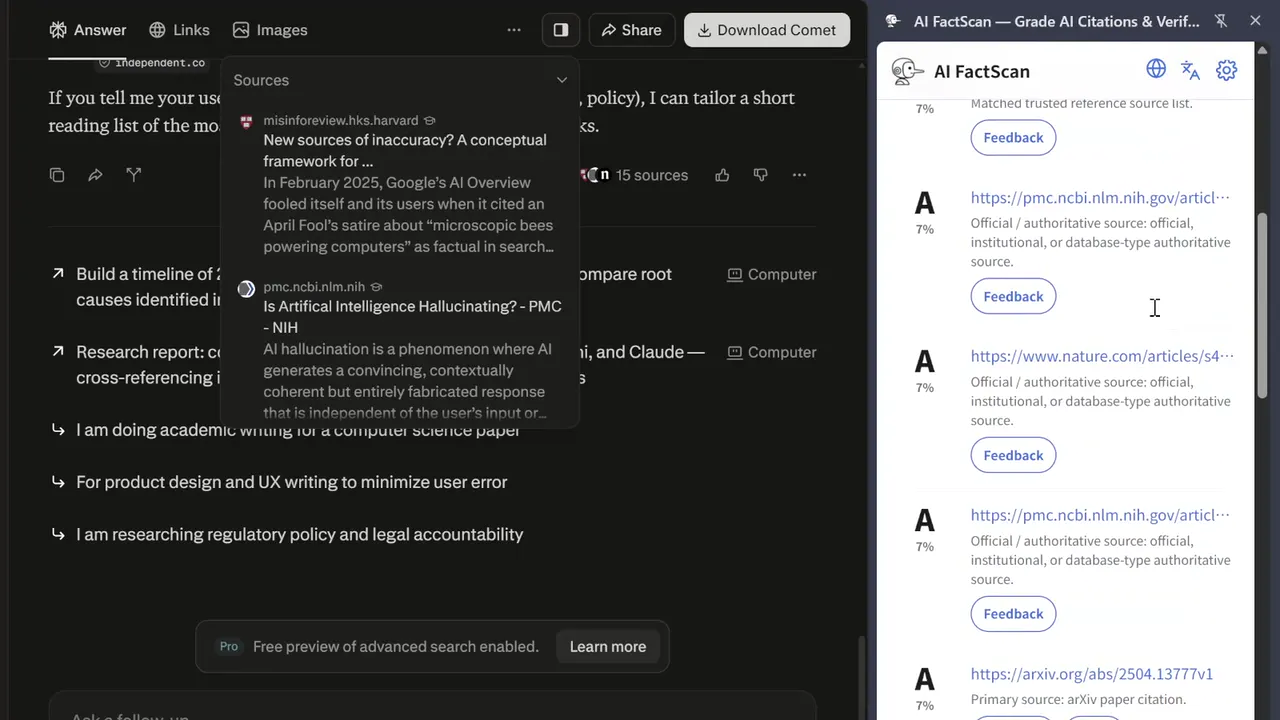
影片中展示了完整的檢查流程:選取回答、一鍵掃描引用、檢視來源評級,並直接點開關鍵文獻進行查證。
步驟 3:把檢測評級當成「先後順序清單」來看
AI FactScan 給出的 A 到 F 等級,並不是對整個回答下最後判決,而是幫你決定「時間該先花在看哪裡」。政府官方公告或國際頂尖期刊研究,跟一篇不知名的個人部落格、套套邏輯的自我引用,或是根本查無此文的虛構編號,本來就該用不同的標準來檢驗。
同時也可以觀察:回答是不是把同一篇文章重複貼了好幾次來充場面?來源是不是都來自少數幾個特定網站?十個引用角標,可絕對不代表十項獨立的一手證據。
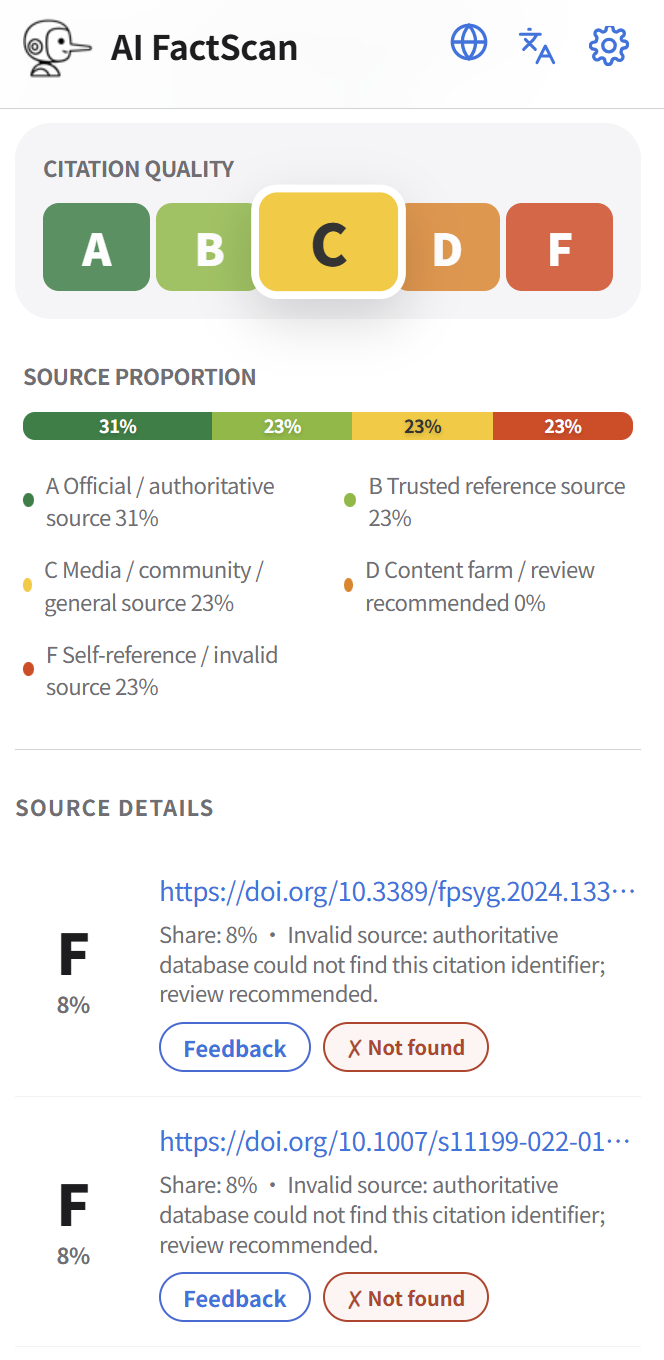
免費安裝 AI FactScan Chrome 擴充功能,親自體驗來源快篩。
步驟 4:點開原始文獻,對照具體主張
這一步是任何演算法都無法代替你完成的。找到 AI 宣稱依賴的那段原文、圖表、統計數字或限制條款,然後把它跟 AI 寫的那句話放在一起比對:
- 這個來源真的做出了相同結論,還是只是剛好聊到相同的話題?
- AI 是不是偷偷把「相關性」擅自腦補成了「因果關係」?
- AI 是不是悄悄刪掉了關鍵的研究限制、調查年份、樣本數量或先決條件?
- 被引用的網頁,本身只是二手轉述別人的報導,而不是真正的一手證據?
如果你在文獻裡怎麼找都找不到對應的佐證,千萬不要回頭去問 AI「你確定嗎?」因為它只會繼續說得更頭頭是道。最可靠的方式,永遠是回到第一手來源本身。
AI FactScan 在這套流程中扮演的角色
AI FactScan 負責幫你搞定最繁瑣的「來源快篩分流」:自動擷取所有引用網址、核對 DOI、arXiv、PubMed 等學術編號真偽、標示來源的權威等級,並一眼揭穿重複灌水與來源過於單一的盲點,幫你把精力集中在真正需要仔細閱讀的核心材料上。
剩下的把關,交給親自閱讀。再知名的頂尖期刊,也可能發表了一篇根本不支持你眼前那句話的論文;看似評級普通的網頁,裡頭也可能正好收錄了你最需要的那份官方一手公文。最後的真實與否,永遠取決於「主張」與「證據」能不能嚴密咬合。
在採納這份摘要前,捫心自問 3 個問題
- 這些核心結論,能追溯到真實存在的一手來源嗎?
- 這些來源的權威程度,足以支撐我即將要做出的決策嗎?
- 在我親自讀過關鍵段落後,我自己也會得出跟 AI 一樣的結論嗎?
AI 摘要確實能幫你省下大把時間;但唯有經過查證,這份省下來的時間才真正有意義,而不是拿更大的錯誤代價去換。